引言
如果你正在读这篇文章,想必最近围绕连续扩散语言模型(CDLM),以及更广义的扩散语言模型的热潮,已经勾起了你的兴趣。如果是这样,欢迎加入!看到越来越多的新朋友关注这个领域,总是让人很高兴。
最初与其他研究者讨论 CDLM 时,我发现,想要对齐彼此的理解,比平时困难得多。有些看似简单的说法,也会引发意想不到的困惑。这个领域发展很快,一部分混乱可以理解;另一部分,我怀疑是宣传有些用力过猛。无论如何,希望这篇文章能帮你少走一些我曾走过的弯路,让接下来的探索轻松一点。
从自回归到扩散
在讨论扩散之前,先退一步,看看大多数语言模型如何生成文本。在这个不断变化的行业里,GPT 式 Transformer 依然占据主导。它们采用熟悉的自回归流程:预测下一个 token,将它接到序列末尾,再重复这一过程。这构成了当今许多领先语言模型的基础。但欲戴王冠,必承其重。这套方法虽然成功,也存在局限,促使研究者探索其他文本生成方式。
扩散是其中一个很有前景的方向,它提供了另一种组织生成过程的方式。训练时,我们先对真实数据样本进行扰动,再教模型逆转这些扰动。生成新内容时,则从噪声出发,反复利用学到的模型逐步细化结果。扩散模型已经在视觉领域证明了自己的价值,人们希望这种成功也能延伸到语言领域。
在语言建模中,扩散大致有两条路线。离散扩散语言模型(DDLM)对离散类别的 token 序列进行扰动,常见做法是用特殊的掩码符号替换 token。连续扩散语言模型(CDLM)则扰动文本的连续表征,通常是在 token 的嵌入向量上添加高斯噪声。生成过程逐步细化这些带噪表征,直到能够将它们解码回 token。
本文聚焦连续扩散语言模型。提到 CDLM,人们常会想到 Transformer 架构、双向注意力、并行生成,以及更快推理的承诺,但这些概念之间的关系并不总是清楚。我们会先简要介绍扩散,再梳理什么才真正定义了 CDLM、哪些特征只是设计选择,以及并行生成在实践中究竟是怎样的。
扩散模型快速入门
在深入细节之前,先简要看看扩散模型如何工作。已经熟悉基础知识的读者,可以直接跳过这一节。
图像是一个很自然的切入点。自回归 Transformer 也许主导着语言建模,但扩散模型一直是图像生成领域的主力。
想象一下,给一张照片逐渐加入随机噪声。起初,图像仍然清晰可辨;随着噪声增多,细节越来越模糊,最后几乎只剩噪声。这就是正向过程:按照预先设定的流程,逐步扰动数据。用数学表达,带噪图像可以写成
其中, 是阶段 的带噪图像, 是原始图像, 是采样得到的高斯噪声。系数 和 控制原始图像与噪声各自的混合比例。
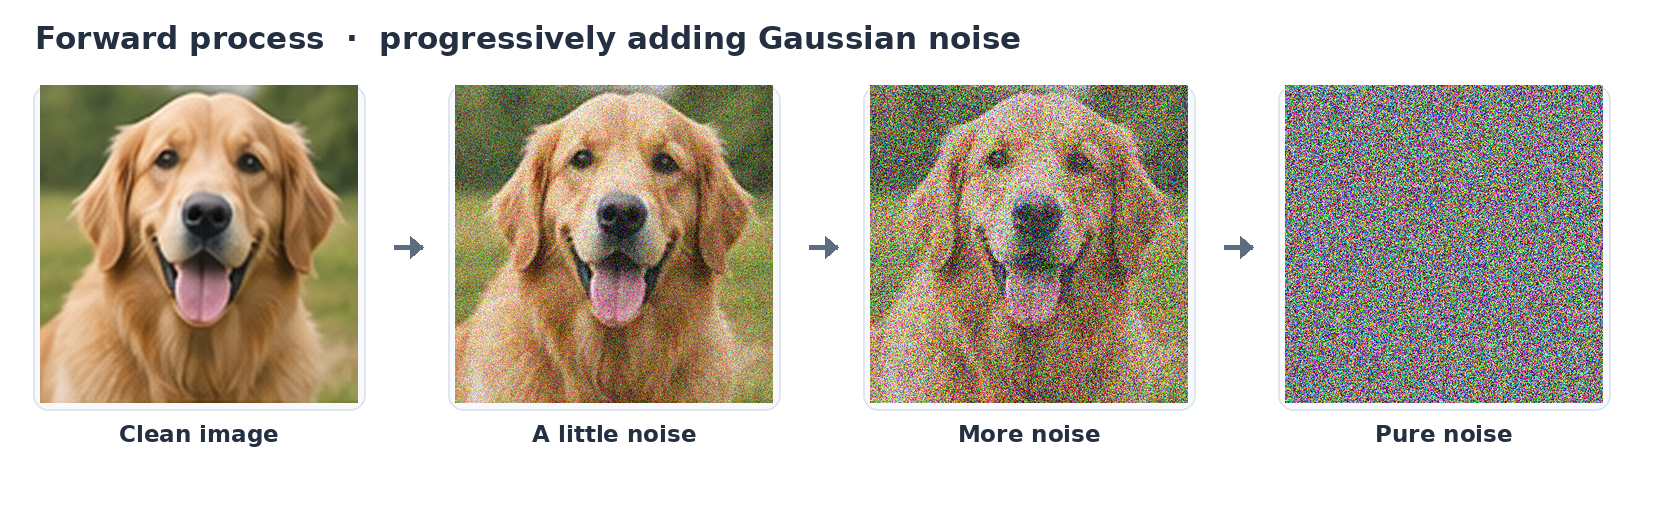
如果能够学会逆转这一过程,我们就可以从噪声中生成新图像。
学习反向过程的一种常见方法,是训练一个称为去噪器的神经网络,让它预测添加到图像中的噪声。我们把带噪图像 及其噪声水平 输入网络,让它估计噪声:
噪声是我们自己添加的,因此我们知道网络应该预测什么。通过在大量图像和不同噪声水平上训练,网络逐渐学会如何引导反向过程。
网络训练好之后,就可以从随机噪声开始生成。我们利用网络的预测完成一步去噪,再将结果送回网络,如此反复。图像便会逐渐成形。这就是下图所示的反向过程。这里生成的是一张新图像,而不是恢复原来的那张照片。
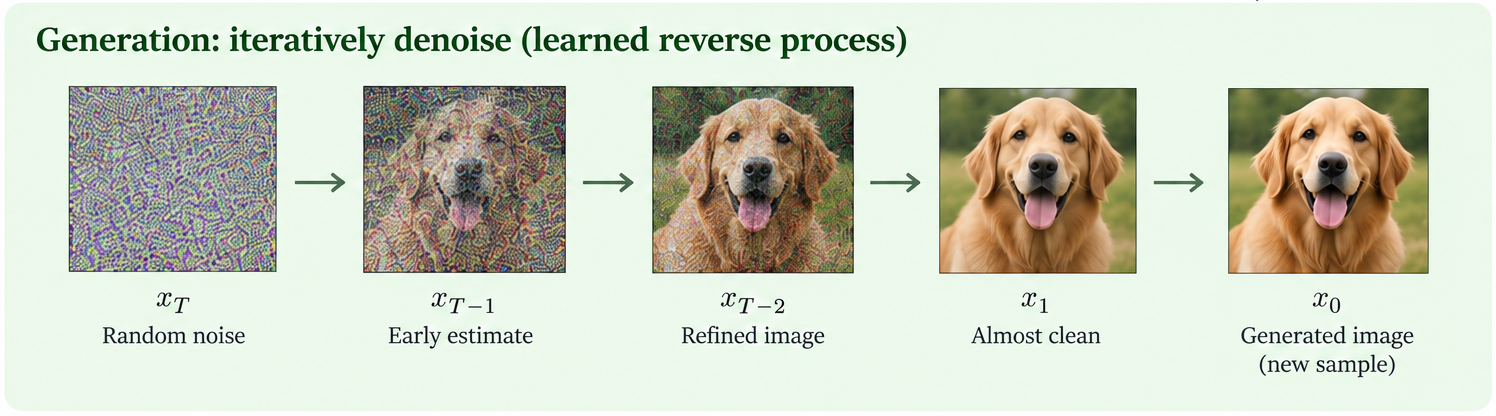
传统的图像扩散模型常使用 U-Net。但扩散本身并不是一种神经网络架构。它描述的是生成过程,用什么网络来实现这个过程,则是另一项设计选择。我们会在第 4 节回到这个区别,因为它对理解语言模型尤其重要。
同样的原理也可以用于语言。不过,这里有一个问题:token 不是像素,我们到底应该往什么上面加噪声?
扩散究竟发生在哪里?
对于图像,添加高斯噪声提供了一种自然的、逐步破坏信息的方式。对于语言,我们首先得决定:究竟要扰动什么?
语言模型使用离散类别的 token表示文本,它们的数值 ID 本质上只是任意分配的标签。即使分词器给两个 token 分别分配了 100 和 101,也不意味着它们在语言上的关系,比 ID 为 100 和 20,000 的两个 token 更接近。因此,直接给这些 ID 加上高斯噪声,并不能得到一种有意义的、逐步扰动文本的方法。
对此,大致有两种处理方式。
离散扩散直接处理离散类别的 token。最常见的形式是掩码扩散:逐步用特殊的 [MASK] 符号替换 token。生成时再逆转这个过程,预测并揭示缺失的 token。不过,掩码并不是唯一选择,有些模型会将 token 替换成从词表中随机选取的其他 token。关键在于,被扰动的状态始终是一个离散 token 序列。
连续扩散采用另一种方式。我们通常不会直接给离散 token 加“噪声”,而是先把每个 token 表示为一个数值向量,也就是嵌入(embedding),再像处理图像那样,对这些向量添加高斯噪声:
其中, 表示 token 序列 的嵌入, 是它的带噪表征。生成时,模型逐步对这些向量去噪,直到能够将它们解码回 token。后续文章会更详细地介绍其中的数学原理。
下面简要对比这两种扰动过程。
| 掩码离散扩散 | 连续扩散 |
|---|---|
New York | token 嵌入 |
[MASK] York | 部分带噪的嵌入 |
[MASK] [MASK] | 高斯噪声 |
这里有一个容易忽略的重要细节:常规 Transformer 的内部本来就在处理连续表征。GPT 式 Transformer 会把输入 token 转换为连续嵌入,离散扩散模型也大致如此。仅仅使用连续向量,并不能让一个模型成为 CDLM。
关键区别在于生成过程中被更新的是什么。离散扩散利用网络的预测,更新由离散 token 和掩码组成的序列;连续扩散则直接更新带噪向量,直到能够将它们解码为文本。CDLM 去噪的是连续向量,而不是离散 token。当然,这并不意味着整个模型完全连续,它们最终输出的仍然是 token。
你可能注意到,我在谈论离散扩散时,会给“噪声”加上引号。随机替换 token 也算是在添加噪声,不过,这有点像把狄拉克 δ 函数称为一种“函数”:所有函数都是平等的,只是有些函数比其他函数更加“平等”。
我个人认为,在连续空间中演化,可能会给 CDLM 带来实际的表达能力优势,尤其是在共同生成多个相互依赖的 token 时。讨论 token 如何共同生成时,我们还会回到这一点。
底层不还是 Transformer 吗?
读到这里,你可能已经发现了那个“深藏不露的秘密”:许多扩散语言模型的底层,依然是 Transformer!人们经常把扩散和 Transformer 当作相互竞争的架构来讨论,但它们描述的根本不是同一件事。还记得图像扩散示例中的去噪网络 吗?在图像扩散中,这个网络传统上是 U-Net;在语言扩散中,它往往是 Transformer。扩散描述生成过程,Transformer 则是用来引导这个过程的网络。
一部分困惑,源于我们已经习惯把 Transformer 与 GPT 的整套方法紧密联系起来。GPT 将 Transformer 架构、因果注意力以及下一个 token 预测训练目标结合在一起,逐个生成 token。扩散语言模型可以保留其中大部分架构,却赋予它不同的任务。掩码 DDLM 可能用网络预测缺失的 token,CDLM 则可能用它对连续表征去噪。扩散模型通常不会立刻选定下一个 token,而是利用反复预测,逐步细化 token 或带噪向量。
双向注意力与分块自回归生成
这就引出了扩散语言模型的另一个常见特征:双向注意力。既然要同时对多个位置去噪,为什么不让它们交换信息呢?与 GPT 式 Transformer 使用的因果注意力不同,双向注意力允许每个位置关注其左侧和右侧的位置。当然,这并不意味着模型能偷看真正的未来文本,它只能利用当前已有的 token、掩码或带噪向量。
这个想法本身并不新鲜。早在扩散语言模型流行之前,BERT 就已经使用双向注意力来预测被掩码的 token。虽然双向注意力很适合同时对多个位置去噪,但它并不是 CDLM 的必要条件。原则上,我们甚至可以使用因果注意力,先对一个 token 去噪,再处理下一个。不过在我看来,这更像是一项消融实验,而不是你真正会部署的方案。
我们也不必一次对整段序列去噪。一种常见方式是分块自回归生成:将输出分成较小的块,再依次生成。块内部仍然可以使用双向注意力,让多个 token 一起细化。每个新块都以已经完成的块为上下文,因此块与块之间的生成是自回归的。
这种方式让生成较长的输出更切实可行。模型在生成后续块时,往往能够保存并复用已完成块的计算结果。
自回归
每次生成一个 token整段序列
扩散
所有位置共同迭代多步分块扩散
每次生成一个块DDLM 和 CDLM 都可以采用这些生成策略。它们描述的是生成如何组织,而离散与连续的区别,在于究竟对什么进行去噪。这也引出了另一个常见误解,可能还是最难理解的一个:同时对多个 token 去噪,并不意味着只用一步就把它们全部生成出来。
预测多个 token,不等于生成多个 token
这里需要把宣传说法与实际过程区分开。人们常说,扩散语言模型能够“一次”生成上百个 token。听起来很厉害,但这个“一次”究竟指什么?
关键是区分对 token 的预测、更新和最终确定。这里的“最终确定”,是指选定那些真正会出现在输出中的 token。模型可以在一次前向计算中预测很多位置,却不最终确定其中任何一个。例如,掩码 DDLM 可能对全部 100 个掩码位置进行预测,却只揭示其中 10 个,然后再做下一次前向计算。CDLM 则可能同时更新 100 个带噪的 token 表征,经过 10 次前向计算逐步细化,再把它们转换为离散 token。
所以,扩散模型确实可以并行处理多个位置,并一起生成整块 token。但这不意味着整个块只经过一次前向计算就生成完成。在刚才的 CDLM 示例中,每次前向计算都会同时更新全部 100 个 token 表征,但完成整个块的生成,依然需要多次前向计算。并行更新 token,与单步生成,是两回事。
即便我们真的能够在一次前向计算中生成 100 个 token,还有一个问题:怎样确保这些 token 组合起来是合理的?
有趣的不只是并行,还有依赖关系
现在,我们来到了我认为 CDLM 尤其有意思的地方。一次生成多个 token 听起来很好,但怎样确保它们组合起来是合理的?连续扩散为这个问题提供了一种颇为优雅的处理方式。
假设我们希望模型补全下面这个句子:
I live in ___ ___.
假设两种等概率的补全结果是 New York 和 Hong Kong。我们希望模型选中其中一个城市,而不是生成 New Kong 或 Hong York 这样的组合。
自回归模型能很自然地处理这个问题:先选择第一个 token,再以这个选择为条件决定第二个。选了 New,就知道后面应该接 York。但如果要同时生成两个 token 呢?若独立采样,第一个位置有各 50% 的概率选中 New 或 Hong,第二个位置也有各 50% 的概率选中 York 或 Kong。即使每个位置各自的概率都正确,最终仍会有一半的组合把两个城市的名字混在一起。
问题在于,每个 token 的概率正确,并不意味着它们的组合概率也正确。用数学表达,在给定当前上下文或去噪状态 的条件下,独立采样两个 token,会得到
这有时被称为因子化问题。仅有双向注意力,并不能解决它。两个位置都可以利用整段序列的信息,但如果最后依然独立地采样每个 token,仍然可能出现不匹配的组合。
在许多掩码 DDLM 中,同一步被揭示的 token,是在给定当前序列的条件下独立采样的。后续步骤可以利用已经做出的选择。例如,一旦选定了 New,下一步就可以利用这一信息来预测 York。因此,这些模型能够随生成过程逐步捕捉依赖关系。真正的挑战,是如何用很少的步骤生成多个相互依赖的 token。
CDLM 提供了建立这些依赖关系的另一种方式。它从带噪的连续向量出发,共同、逐步地细化这些向量。去噪网络可以利用所有位置的信息,使各个位置的表征在最终 token 尚未确定之前,就能够相互影响。
关键在于,模型从一个步骤传递到下一个步骤的状态是什么。在标准的掩码 DDLM 中,每个位置要么被掩码,要么由一个离散 token 表示。CDLM 传递的则是连续向量,它可以逐渐变化,并在尚未变成 token 之前影响其他位置。在刚才的例子里,两个最终 token 的选择都还没有被固定下来时,它们的表征就已经能够共同趋向一个一致的城市名称。
即便每个位置的初始噪声是独立采样的,最终 token 也不必相互独立。模型共同变换这些带噪向量,使同一份初始随机性能够影响多个最终 token 的选择。独立的初始噪声,可以变成协调一致的输出。
离散模型同样能够协调 token 的选择。有些模型会使用共同选择相关 token 的采样器,而不是逐个独立采样。连续扩散的吸引力在于,它能够通过向量本身的渐进变化,逐步形成这种协调。至于需要多少步才能做好,则是另一个需要研究的问题。
对我来说,CDLM 真正的潜力,并不只是并行生成更多 token,而是在不必逐一做出每个决定的情况下,共同生成相互依赖的 token。
究竟什么才定义了 CDLM?
梳理完这些问题,核心定义其实很简单:
连续扩散语言模型通过对连续向量去噪来生成文本,再将这些向量解码为 token。
这才是真正的定义性特征。前面讨论的其他内容,要么是常见的设计选择,要么是潜在优势,而不是 CDLM 必然具备的性质。
下面用一张清单快速回顾:
| 特征 | 需要记住的要点 |
|---|---|
| 连续的生成状态 | 必需。这是 CDLM 的定义性特征。 |
| Transformer 架构 | 常见,但并非必需。 |
| 双向注意力 | 常见,但并非必需。 |
| 并行更新多个 token | 常见,但并非必需。 |
| 整段序列生成 | 可选。分块自回归生成也很常见。 |
| 共同生成相互依赖的 token | 一个重要吸引力,但并不保证实现。 |
| 比自回归模型更快 | 不一定。去噪本身也有计算开销。 |
希望读完之后,CDLM 对你来说不再那么神秘,也不再那么难以接近。这些都是我刚开始研究它们时,曾经感到困惑的问题。如果你想继续深入,我们会在后续文章中探讨技术细节、发展历史和设计选择。
XOXO, K
延伸阅读
- Sander Dieleman,Continuous diffusion language models(2026)——对 CDLM 的历史与近期发展进行了深入讨论。
- Li 等,Diffusion-LM Improves Controllable Text Generation(2022)——将连续扩散用于语言的一项早期工作。
- Sahoo 等,Simple and Effective Masked Diffusion Language Models(2024)——理解掩码离散扩散视角的一份实用参考。
- Gloeckle 等,Better & Faster Large Language Models via Multi-token Prediction(2024)——提醒我们,同时预测多个未来 token,并不是扩散模型独有的能力。
- Arriola 等,Block Diffusion(2025)——块之间采用自回归生成,块内部采用扩散。
- Li 等,Breaking the Factorization Barrier in Diffusion Language Models(2026)——讨论并行类别采样中的依赖关系问题。